Primitives des agents IA
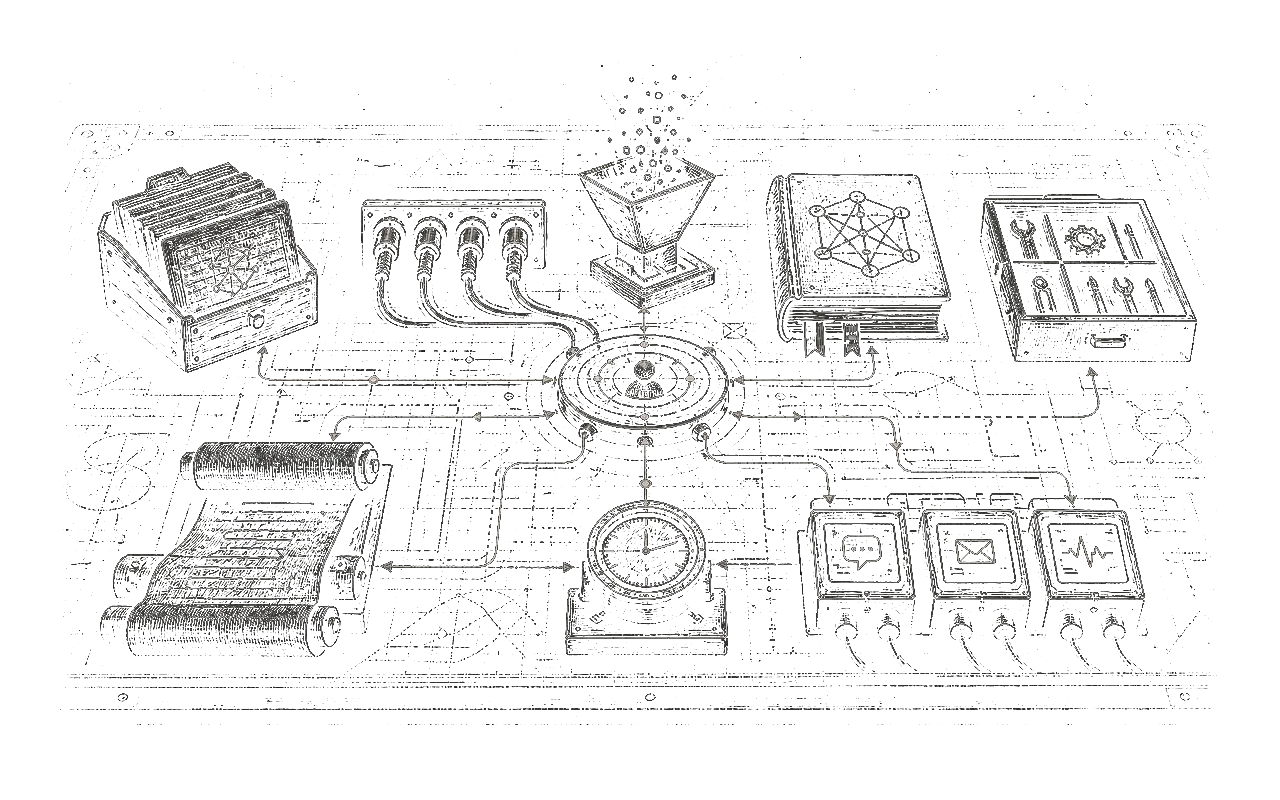
Je veux expliquer ce dont une entreprise IA a besoin pour fonctionner sur le long terme. Ces primitives sont partout dans les outils actuels et elles sont là pour durer.
Je vais expliquer ce qu’elles sont et pourquoi nous en avons besoin. Et pour chaque pièce, je donnerai l’équivalent humain.
Skills
Un skill est une recette que vous pouvez partager avec n’importe qui. Il contient des exemples de comment faire quelque chose. Il ne faut pas trop le compliquer : c’est vraiment un tutoriel sur une tâche spécifique.
Exemples de skills :
- Comment formater correctement un texte pour envoyer un message Slack
- Comment analyser un log pour extraire un bug
- Quel ton de voix utiliser dans un email
- Comment utiliser l’API Gmail
- Comment analyser et résoudre un ticket de support client
- Quelles sont les meilleures pratiques pour la conversion d’une landing page
Vous commencez à voir un pattern : les skills peuvent être génériques ou spécifiques à votre entreprise. Comment utiliser l’API Gmail est générique pour n’importe quelle entreprise dans le monde, mais comment résoudre un ticket de support client vous est spécifique.
C’est pourquoi j’aime séparer les skills en deux catégories : - publics : vous pouvez les partager avec le monde. - privés : ils contiennent des données et des processus privés de votre entreprise qui ne peuvent pas être partagés.
Les skills seront utilisés dans les agents et les channels (plus bas). Vous devez les traiter comme des citoyens de première classe et les revoir pour vous assurer qu’ils sont à jour.
Un skill est un dossier avec :
- Un fichier racine nommé SKILL.md
- Peut inclure des références dans un dossier references/.
- Peut inclure des scripts dans un dossier scripts/.
Équivalent humain : - « Tu peux parler à Roberto quand tu veux déployer une nouvelle landing page, il sait comment faire. » - « Appelle Andrea pour le bug report sur l’automatisation n8n. » - « Écris à Michel à propos du ticket que tu traites, je suis sûr qu’il sait quelque chose qui peut t’aider. »
Connectors
Le connector est la pièce de “code” qui connecte votre agent au monde extérieur : Slack, Gmail, n8n, Google Drive, etc.
J’aime séparer les connectors en deux catégories : - Read-Only : ils peuvent seulement récupérer des données, mais jamais les modifier. Par exemple, un connector pour lire des emails mais jamais en envoyer. - Read-Write : ils peuvent modifier des données. Comme envoyer des messages Slack, rédiger des emails, modifier une Google Spreadsheet.
Vous devez savoir exactement quel connector est utilisé et où. Bien sûr, vous traitez les connectors Read-Write comme “dangereux” et vous les surveillez.
Un connector, c’est un accès API Token à un service et du code pour parler à l’API :
- SLACK_ACCESS_TOKEN_READ_ONLY=.....
- send_slack_message.py
Vous pouvez utiliser MCP pour vous connecter à des services, mais je préfère posséder toute la stack et avoir des scripts dédiés pour cela.
Équivalent humain : - Compte Gmail - Compte Drive - Compte n8n - Compte Slack
Ingestors
Ce sont des morceaux de “code” qui utilisent un connector en “read-only” pour importer des données dans la mémoire (plus bas). Un ingestor est du code pur (pas un agent). Il tourne selon un planning, par exemple toutes les heures, pour récupérer des données du monde extérieur. Ces données seront ensuite utilisées pour donner du contexte aux agents.
Un connector peut prendre différentes formes, mais la plupart du temps c’est un simple script Python qui sauvegarde des données dans un dossier :
- ingest_gmail.py
- output vers : emails/<YYYY>/<MM>/<DD>/<id>.eml
Équivalent humain : - Chercher un thread dans Slack - Chercher un mail dans Gmail - Regarder les logs de Make et n8n
Wiki
Les agents ont besoin de contexte pour effectuer une tâche.
Un wiki est une source de vérité pour votre entreprise.
Il suit l’idée du Karpathy LLM Wiki.
C’est une manière simple d’organiser la connaissance dans un graphe. Une page peut pointer vers une autre, etc.
Le but est que les agents naviguent dans le wiki pour rassembler le contexte d’une tâche.
Un wiki sert surtout à stocker des apprentissages sur des choses spécifiques.
Le jeu consiste à extraire des données du wiki et à les transformer plus tard en skill, mais avoir le wiki aide déjà.
Le contenu du wiki est daté et garde une trace détaillée de ce qui s’est passé dans le passé.
Il peut inclure des éléments spécifiques à un client, comme une page dans wiki/pages/clients/nike.md :
« ils aiment avoir leur logo sur chaque page de leurs documents parce qu’ils sont très orientés marque. »
C’est un très petit exemple. Vous pouvez stocker beaucoup d’informations précieuses venant de messages Slack, d’emails et de logs.
Comme un wiki peut contenir des informations sensibles, j’aime avoir plusieurs wikis, par exemple un global (safe, préféré) et un wiki par équipe :
- general/wiki
- sales/wiki
- engineers/wiki
- support/wiki
Ce n’est pas obligatoire et je recommande de tout avoir dans un seul wiki. Mais parfois vous voulez isoler des données client dans un autre wiki pour éviter d’exposer trop de contexte aux agents.
Équivalent humain : - « Brandon, j’essaie de closer un deal avec Nike, c’était quoi le nom du designer qui travaillait sur le projet en 2022 ? J’ai besoin de lui parler avant, je suis sûr que ça aidera » - « Je ne me souviens plus des problèmes récurrents qu’on a eus sur l’automatisation Make pour Airbus. J’ai besoin de chercher la cause racine et ce qu’on a appris l’année dernière. »
Tools
Un agent fera probablement une action plusieurs fois. Une bonne manière d’avoir un agent efficace est d’avoir du software efficace. Un tool est un simple script Python qui fait une tâche, comme convertir une image de PNG en JPEG. Ou un script qui extrait une valeur spécifique d’une page HTML.
Le but est que l’agent écrive lui-même les tools dont il a besoin pour son cas d’usage et les réutilise ensuite. C’est aussi plus efficace en tokens, parce que vous ne voulez pas que votre agent réinvente, découvre et cherche comment convertir un PNG tout le temps.
Équivalent humain : - Ouvrir Photoshop et créer une macro (au lieu de réappliquer le même filtre encore et encore). - Créer une requête SQL pour récupérer des données spécifiques nécessaires à une tâche au lieu de scroller et copier-coller depuis une feuille Excel. - Ajouter des sites web en favoris au lieu de les chercher dans Google à chaque fois. - Ouvrir une présentation dans PowerPoint et l’exporter en PDF pour l’envoyer par email.
Agents
Enfin ! Un agent est la “colle” entre tous les concepts ci-dessus. Un agent est défini par :
- une liste de skills
- une liste de connectors
- une liste de tools
- un accès au wiki
- un objectif
- un input
- un output
Un agent doit être une couche fine capable d’avoir le bon contexte pour opérer.
Un agent produira probablement des fichiers (documents, images, vidéo, etc.) comme output, mais je l’oblige aussi à générer un report.
J’ai une guideline générale pour mes agents qui leur fait produire un output standard à chaque run : Un report Markdown et une version JSON :
home/runs/<YYYY-MM-DD>/<ISO-8601_timestamp>-report.mdhome/runs/<YYYY-MM-DD>/<ISO-8601_timestamp>-output.json
Corps de report.md :
# Run Report
## Summary
## Input
## Actions
## Output
## Errors
## Assumptions
## Files and Artifacts
## Follow-ups
## Learnings
De cette façon, je peux lire les reports et apprendre des choses tout le temps. Si quelque chose a de la valeur, je l’inclus dans le skill ou dans les instructions de l’agent selon le feedback.
Par exemple, je me souviens avoir eu un agent avec une instruction comme :
- GET the list of entries in the api at https://api.foo.com/api/entries
Et je ne comprenais pas pourquoi ça prenait une heure. Puis j’ai lu le report et j’ai vu :
## Learnings
The good API url is https://api.foo.com/api/v1/entries
and not https://api.foo.com/api/entries.
The agent finally found it but it was a bad instruction.
Damn. J’ai corrigé la faute dans l’instruction (en ajoutant le /v1 si vous ne l’aviez pas vu) et c’était tout.
Ce genre d’erreur est difficile à repérer sans report.
La deuxième raison d’avoir toujours un report est de pouvoir apprendre sur l’agent sur le long terme. « Lis tous les reports de l’agent et dis-moi quelles instructions je peux modifier pour obtenir de meilleurs résultats »
Memory and Logs
Un autre effet secondaire des agents est de générer une sorte de mémoire et des logs en dehors du report.
Claude Code, Codex, Pi Agent et d’autres ont un mécanisme interne de “sessions” ou “project” pour stocker toute la trace de l’agent dans un fichier .jsonl. C’est utile à garder (j’utilise un agent pour les centraliser par date) parce que vous pouvez aussi beaucoup apprendre à partir de ça.
La plupart des harness ont aussi un système de “memory” qui sauvegarde les conversations en Markdown (nanoclaw) ou une couche “auto memory”.
Je n’aime pas l’utiliser parce que je veux un contrôle total sur la mémoire.
Avoir le wiki + les reports + les logs en JSON suffit pour avoir un système de mémoire solide.
Je garde quand même les fichiers de mémoire officiels générés au cas où j’aurais besoin d’avoir le “contexte complet” pour débugger un agent.
Scheduled Jobs
Quand vous avez tout ce qui précède, vous pouvez planifier un agent pour tourner toutes les heures, tous les jours, etc. C’est aussi simple que ça. La plupart des systèmes IA ont un scheduler pour lancer des tâches quotidiennement.
Dream cycle
Je l’appelle REM Sleep Cycle : C’est un agent qui lit tous les reports produits par tous les agents et crée un résumé, chaque nuit, de ce qui peut être amélioré dans le processus général. C’est utile parce que ça vous oblige à garder un œil sur vos agents et à les surveiller correctement.
Channels
Quand vous utilisez un outil comme hermes ou nanoclaw, un channel est une manière de communiquer avec vos agents. J’aime avoir un channel par “projet”. Un channel a des Skills, des Connectors, un accès au wiki (comme les agents). Un channel ne déclenche rien tout seul comme un agent. Vous pouvez déclencher un agent depuis le channel. Vous pouvez poser des questions ponctuelles dans le channel. Le channel peut être utilisé pour vous notifier quand un agent démarre et termine, avec un lien vers le report.
Conclusions
Codex, Claude Code et les autres outils de coding IA fonctionnent tous avec ces primitives. Elles semblent maintenant stables et claires. J’ai passé les 6 derniers mois à expérimenter avec des agents et j’ai l’impression d’être arrivé à un point où je n’ai besoin de rien de plus que ça pour accomplir n’importe quelle tâche avec l’IA. Bien sûr, on peut avoir de meilleurs “reports”. J’aime le travail récent de Google “Open Knowledge Format”, qui essaie d’avoir une manière formelle de structurer le wiki. C’est une très bonne lecture et cela confirme que la primitive Wiki est une manière très simple d’organiser les données pour les humains et pour les agents.
Le défi des workflows d’agents est de garder les skills et le wiki à jour. La revue humaine est essentielle pour garder le système sain.